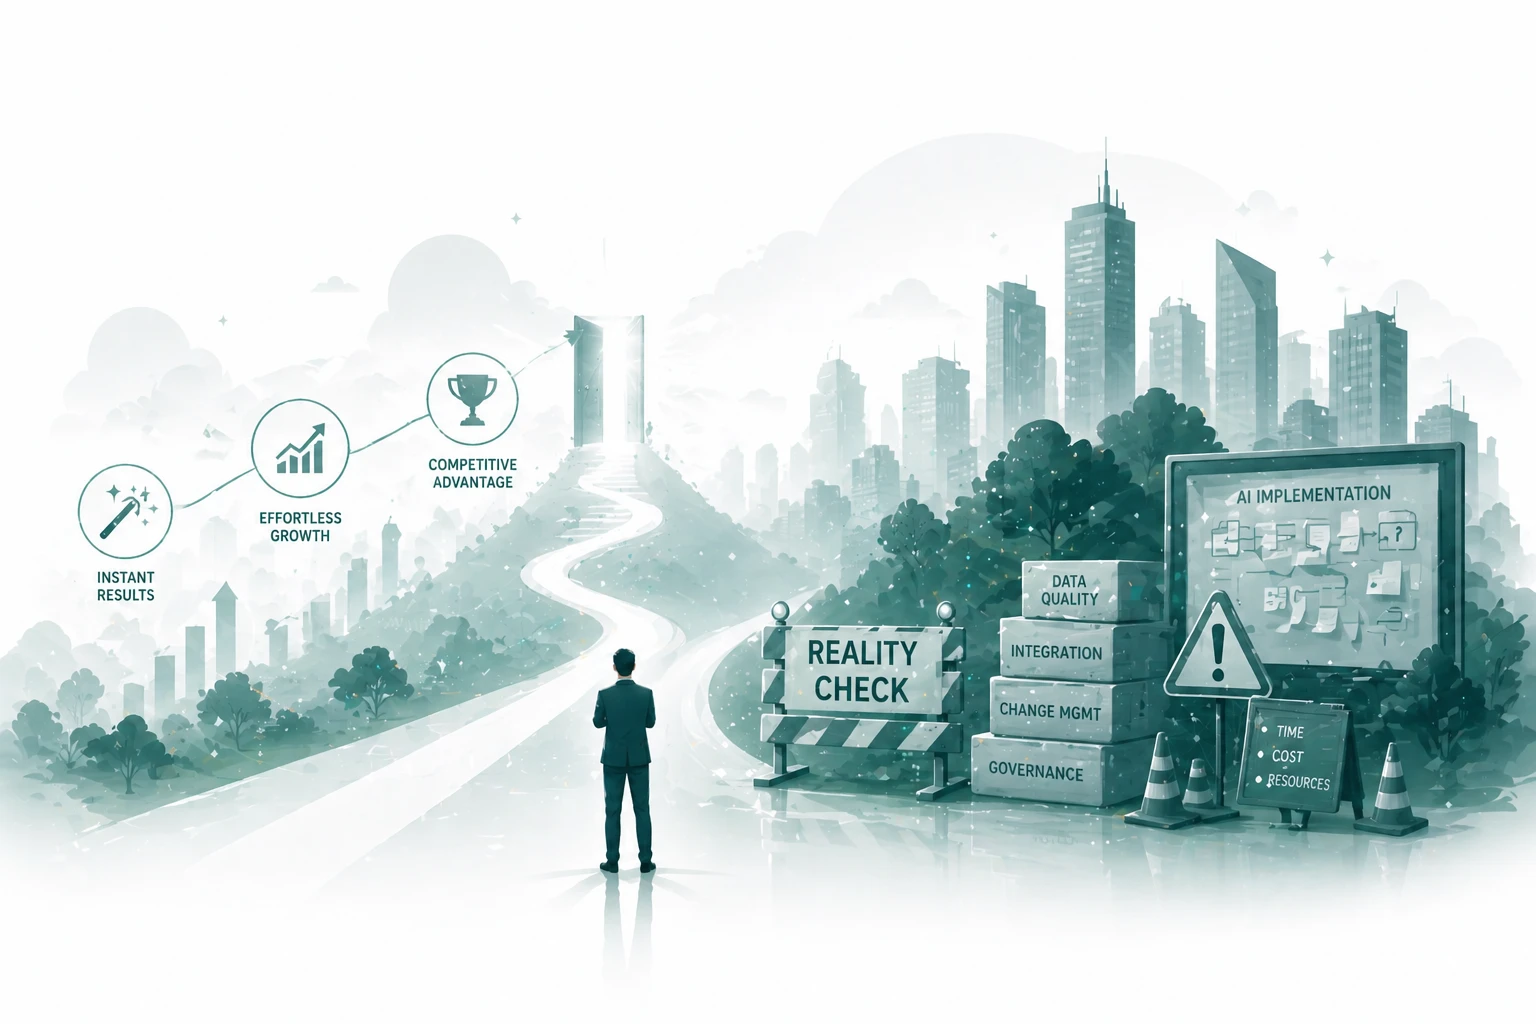
Realitäts-Check: KI ist (noch) keine Magie
Im August 2025 trafen drei Realitäts-Checks in kurzer Folge ein: Das MIT-Projekt NANDA stellte fest, dass rund 95 Prozent der unternehmensweiten GenAI-Pilotprojekte keinen P&L-Effekt zeigen, OpenAIs lang erwartetes GPT-5 kam als Iteration statt als Sprung, und Apples Reasoning-Studie dokumentierte harte Grenzen, an denen heutige Modelle tatsächlich scheitern. Die Ära, in der man KI wie Magie behandelt, geht zu Ende – die Ära, in der man sie wie ernsthaftes Engineering behandelt, beginnt.
Im August 2025 trafen drei Realitäts-Checks in kurzer Folge ein. Das MIT-Projekt NANDA veröffentlichte "The GenAI Divide: State of AI in Business 2025" und stellte fest, dass rund 95 Prozent der unternehmensweiten Pilotprojekte mit generativer KI keinen messbaren P&L-Effekt zeigen. OpenAI brachte GPT-5 heraus – die Resonanz war so gemischt, dass das Unternehmen GPT-4o innerhalb einer Woche zurückbrachte. Und Apples Reasoning-Studie kursierte weiter und dokumentierte harte Komplexitätsgrenzen, an denen heutige Reasoning-Modelle schlicht zusammenbrechen. Das heisst nicht, dass KI nicht nützlich ist. Es heisst, dass die Ära, in der man sie als Magie behandelt, endet – und die Ära, in der man sie wie ernsthaftes Engineering behandelt, beginnt.
Drei Jahre lang lautete das Unternehmensnarrativ, dass die Fähigkeiten der KI exponentiell zunähmen und die einzige relevante Frage die der Adoption sei. Ende August 2025 hat die Datenlage das Gespräch verändert. Fähigkeitszuwächse sind weiterhin real, aber die Lücke zwischen dem, was demonstriert wird, und dem, was in der Produktion überlebt, ist messbar, wiederholbar – und an drei Stellen unstrittig geworden.
Die 95-Prozent-Erkenntnis
Mitte August veröffentlichte das MIT-Projekt NANDA "The GenAI Divide: State of AI in Business 2025". Die Schlagzeile, die in jedem Vorstandsdeck landete: Von den über 300 untersuchten Unternehmens-Pilotprojekten mit generativer KI aus 2024 und dem ersten Halbjahr 2025 zeigten rund 95 Prozent keinen messbaren Einfluss auf Gewinn und Verlust. Die Forschenden bezeichneten das als "GenAI-Kluft" – eine kleine Gruppe von Unternehmen, die echten Wert generiert, und eine deutlich grössere, deren Pilotprojekte nie über das Pilotstadium hinauskommen.
Die genannten Gründe überraschten nicht. Den meisten Piloten fehlten ein klar definiertes Ausgangsniveau, ein vorab vereinbarter Messrahmen, die Integration in die Daten und Arbeitsabläufe, die das Geschäft tatsächlich treiben, und eine Governance-Haltung, die stark genug ist, das Modell überhaupt in die Nähe sensibler Inhalte zu lassen. Erfolg im Sandbox-Pilot übersetzt sich nicht in P&L-Wirkung, wenn das Modell die Daten, auf die es ankommt, gar nicht erreicht.
Die Zahl, die jede CIO beunruhigen sollte, ist nicht 95. Es ist die implizite Folgerung: Die 5 Prozent, die Erfolg hatten, hatten keine besseren Modelle. Sie hatten bessere Messung, bessere Integration und bessere Governance.
GPT-5: Iteration, kein Sprung
Am 7. August 2025 veröffentlichte OpenAI GPT-5. Der Launch war als nächster diskontinuierlicher Sprung positioniert – die ehrgeizigste Veröffentlichung des Unternehmens und eine öffentliche Antwort auf die Frage, ob die Skalierungsgesetze noch gelten. Die Resonanz traf den Anspruch nicht.
Innerhalb einer Woche zeichneten sich zwei Dinge ab. Erstens: Die zugrunde liegenden Fähigkeitsgewinne waren real, aber inkrementell statt revolutionär – besser im Coding, besser bei mehrstufigem Reasoning, leicht besser in den meisten Evaluierungen, aber weit entfernt vom qualitativen Sprung von GPT-3.5 zu GPT-4. Zweitens: Der Rollout selbst verlief holprig. Eine Routing-Schicht machte GPT-5 am ersten Tag inkonsistent, und die Abkündigung von GPT-4o löste eine Nutzerwelle aus, die OpenAI dazu brachte, GPT-4o innerhalb weniger Tage wiederherzustellen. Sam Altman räumte den Fehlgriff öffentlich ein.
Die Lehre lautet nicht, dass GPT-5 gescheitert sei – es ist tatsächlich das leistungsfähigste Modell, das OpenAI bisher ausgeliefert hat. Die Lehre lautet, dass der mit Abstand am meisten erwartete KI-Launch des Jahres 2025 sich als Iteration entpuppte, nicht als Sprung. Unternehmen, die ihre Strategie auf die Annahme kontinuierlicher diskontinuierlicher Durchbrüche aufgebaut haben, müssen für eine Kurve planen, die sich eher biegt, als springt.
Wo Reasoning-Modelle tatsächlich scheitern
Der dritte Realitäts-Check ist älter, reifte aber im Verlauf des Sommers. Apples Juni-Studie "The Illusion of Thinking" – verfasst von Parshin Shojaee, Iman Mirzadeh und Kollegen – nutzte kontrollierte Puzzle-Umgebungen (Türme von Hanoi, Flussüberquerungs-Varianten, Blocks-World-Aufgaben), um die neuesten Reasoning-Modelle zu testen, darunter DeepSeek-R1 und Claude 3.7 Sonnet im Extended-Thinking-Modus. Sie identifizierten drei Regime: Bei niedriger Komplexität schneiden Standardmodelle besser ab als Reasoning-Modelle, bei mittlerer Komplexität hilft Reasoning, bei hoher Komplexität brechen beide Regime auf nahezu null Genauigkeit ein – und Reasoning-Modelle nutzen oft sogar weniger Denk-Tokens, kurz bevor sie scheitern.
Die Studie erntete im Sommer Repliken – darunter eine pointierte Antwort mit dem Titel "The Illusion of the Illusion of Thinking" – aber der zentrale Befund hielt stand: Heutige Reasoning-Modelle leisten kein vollständig generelles Reasoning. Sie führen mustererkennende Suche über Verteilungen aus, die sie gesehen haben. Diese Unterscheidung ist in der Produktion entscheidend. Liegt die Aufgabenverteilung gut in den Trainingsdaten und sind die Argumentationsketten kurz, sind diese Modelle spektakulär. Wenn nicht, scheitern sie auf eine Weise, die selbstbewusst klingt.
Für ein Unternehmen lautet die Frage damit nicht mehr "Ist das Modell schlau genug?", sondern "Liegt diese Aufgabe innerhalb der Verteilung, in der das Modell verlässlich ist, und woher wissen wir, wenn nicht?"
Was das für europäische Unternehmen bedeutet
Für Organisationen in der Schweiz, in Deutschland und im weiteren EU-Raum hat der August 2025 drei operative Implikationen.
Erwartungen der Geschäftsleitung an die Daten anpassen. Die 95-Prozent-Zahl ist kein Angriff auf KI. Sie ist die Reifekurve, die jede transformative Technologie durchläuft. Cloud, Mobile, sogar ERP hatten alle Jahre, in denen das Marketing den realisierten Nutzen überholte. Die richtige Antwort ist nicht weniger Ehrgeiz – es sind ehrlichere Messung und die Bereitschaft, Pilotprojekte abzubrechen, die keine Zahl bewegen.
Auf hybride Intelligenz setzen, nicht auf Autonomie. Die Klarna-Kehrtwende im Mai, der GPT-5-Rollout im August und Apples Studie weisen alle in dieselbe Richtung: Heutige Modelle sind starke Mitarbeitende, keine autonomen Arbeitskräfte. Die Architektur, die überlebt, ist Human-in-the-Loop mit klaren Eskalationspfaden – nicht "Fire and forget"-Agenten auf kritischen Arbeitsabläufen.
Governance ist jetzt ein Werthebel, keine Steuer. Die 5 Prozent der Organisationen, die P&L-Wirkung erzielten, taten dies, indem sie ihren Modellen Zugriff auf die Daten und Arbeitsabläufe gewährten, auf die es ankommt. Sie konnten das nur tun, weil sie eine Governance-Haltung hatten – Data-Loss-Prevention, rollenbasierter Zugriff, Audit-Pfade, Retention-Steuerung – die stark genug war, um diesen Zugriff verteidigbar zu machen. In regulierten Branchen lautet die Reihenfolge: Governance zuerst, dann Wert. Es gibt keine andere Reihenfolge, die einen Audit übersteht.
Das "Noch"
Die ehrliche Lesart des August 2025 lautet nicht "KI funktioniert nicht". Sie lautet "KI ist keine Magie – und war es nie". Die Systeme sind aussergewöhnlich, die Produktivitätsgewinne bei eng definierten Aufgaben sind real, und die Trajektorie bleibt aufwärtsgerichtet. Was sich verändert hat, ist, dass das Feld genug Narben gesammelt hat, um zu wissen, was nicht funktioniert: naive Autonomie auf kritischen Arbeitsabläufen, Pilotprojekte ohne Messung, Fähigkeitsversprechen ohne Governance und die Annahme, das nächste Modell werde die Integrationsprobleme des letzten Quartals lösen.
Für europäische Unternehmen ist dieser Realitäts-Check eine Chance, keine Bedrohung. Die Unternehmen, die die nächsten zwei Jahre gewinnen, sind diejenigen, die bereits so operieren, als hätte die Magie nie existiert – Ergebnisse messen, Zugriff steuern und KI ihr Budget auf die gleiche Weise verdienen lassen, wie es jede andere Unternehmensinfrastruktur musste.